起因
这件事的开端有些离奇,Y7n05h 在完成 Leetcode 题目 LRU Cache 时写出了这样的代码:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
| class LRUCache {
struct DoubleLinkListNode {
DoubleLinkListNode *prev;
DoubleLinkListNode *next;
int key;
int value;
};
class DoubleLinkList {
DoubleLinkListNode head;
DoubleLinkListNode tail;
public:
int size{};
DoubleLinkList() {
head.prev = nullptr;
head.next = &tail;
tail.next = nullptr;
tail.prev = &head;
}
void moveToHead(DoubleLinkListNode *node) {
node->prev->next = node->next;
node->next->prev = node->prev;
node->next = head.next;
node->prev = &head;
head.next->prev = node;
head.next = node;
}
DoubleLinkListNode *back() const {
return tail.prev;
}
DoubleLinkListNode *newNode(int key, int value) {
auto *node = new DoubleLinkListNode;
node->next = head.next;
node->prev = &head;
head.next->prev = node;
head.next = node;
node->key = key;
node->value = value;
++size;
return node;
}
};
public:
LRUCache(int capacity) : cap(capacity) {
}
int get(int key) {
try {
auto *node = map.at(key);
list.moveToHead(node);
return node->value;
} catch (std::out_of_range &) {
return -1;
}
return -1;
}
void put(int key, int value) {
try {
auto *node = map.at(key);
node->key = key;
node->value = value;
list.moveToHead(node);
} catch (std::out_of_range &) {
if (list.size == cap) {
auto *node = list.back();
map.erase(node->key);
map[key] = node;
node->key = key;
node->value = value;
list.moveToHead(node);
} else {
auto *node = list.newNode(key, value);
map[key] = node;
}
}
}
int cap = 0;
DoubleLinkList list;
unordered_map<int, DoubleLinkListNode *> map;
};
|
这样的代码虽然被 Accept 了,但性能并不好,在运行时间上只击败了 5% 的 C++ 提交。对此成绩,Y7n05h 属实不能接受。
代码中对以元素的查找都是的,链表的访问也都是从头尾访问或是直接通过指针访问链表节点,甚至链表节点也会被复用,减少内存分配器的开销。
排除众多无可优化之处,Y7n05h 凭借直觉认为是 异常 拖慢了程序的运行。
这也好办,只需修改 LRUCache::get 和 LRUCache::put 即可。可以看到,代码中对异常的应用实际上只有用来检测 key 是否在 map 中。那么改用 std::unordered_map::count 来判断就好。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
| int get(int key) {
if (map.count(key) == 0)
return -1;
auto *node = map.at(key);
list.moveToHead(node);
return node->value;
}
void put(int key, int value) {
if (map.count(key)) {
auto *node = map.at(key);
node->key = key;
node->value = value;
list.moveToHead(node);
return;
}
if (list.size == cap) {
auto *node = list.back();
map.erase(node->key);
map[key] = node;
node->key = key;
node->value = value;
list.moveToHead(node);
} else {
auto *node = list.newNode(key, value);
map[key] = node;
}
}
|
修改后,代码的运行时间击败了 90% 左右的提交。
那么问题来了,为什么一个异常对性能的影响这么大?
性能分析
为了本地环境测试两版程序的性能,Y7n05h 编写了如下测试代码:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| int main() {
LRUCache cache(2);
for (int i = 0; i < 1000000; i++) {
cache.put(1, 0);
cache.put(2, 2);
printf("%d\n", cache.get(1));
cache.put(3, 3);
printf("%d\n", cache.get(2));
cache.put(4, 4);
printf("%d\n", cache.get(1));
printf("%d\n", cache.get(3));
printf("%d\n", cache.get(4));
}
}
|
两版程序均使用相同的编译参数进行编译:
1
| clang++ -stdlib=libc++ -O2 -flto -g lru1.cpp
|
为了尽可能展现现代 C++ 程序所能获得的编译器优化后的性能差异,Y7n05h 开启了 O2 和 lto。
测试环境:
1
2
3
4
5
6
| clang version: 13.0.1
libc++: 13.0.1
Linux Kernel version: 5.17.5
glibc version: 2.35
gcc-libs: 11.2.0
perf: 5.17
|
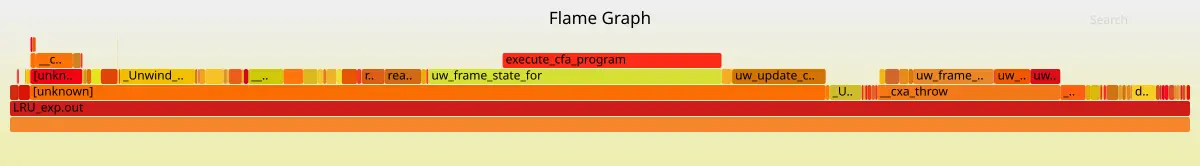
这是使用异常机制的程序性能火焰图:
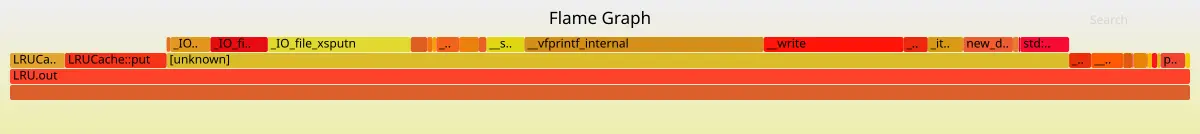
这是不使用异常机制的程序性能火焰图:
如果这还不够明显,那还可依看看 perf diff 的输出:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| 21.05% -19.30% libc.so.6 [.] __vfprintf_internal
+18.98% libgcc_s.so.1 [.] execute_cfa_program
+13.11% libgcc_s.so.1 [.] uw_frame_state_for
12.12% -11.31% libc.so.6 [.] _IO_file_xsputn
11.84% -10.64% libc.so.6 [.] __write
+10.49% libgcc_s.so.1 [.] uw_update_context_1
+9.05% libgcc_s.so.1 [.] _Unwind_IteratePhdrCallback
+4.76% libc++abi.so.1.0 [.] __gxx_personality_v0
4.86% -4.48% libc.so.6 [.] _IO_file_write
4.20% -3.84% libc.so.6 [.] new_do_write
+3.60% libc++abi.so.1.0 [.] __cxa_call_unexpected
+3.47% libgcc_s.so.1 [.] uw_install_context_1
+3.44% libgcc_s.so.1 [.] read_encoded_value_with_base
+3.28% libc.so.6 [.] __strlen_avx2
|
可以看到 execute_cfa_program、uw_frame_state_for、uw_update_context_1 在改动前后变化很大。一个重要线索是这些和栈展开有关的函数都在 libgcc_s.so.1 中。
从此处可知, clang 编译的程序也是使用 libgcc 实现的栈展开机制。
异常的实现
在此前 Y7n05h 只知道异常的原理是栈展开,但对细节一概不知道。借这次的机会来稍微看看异常处理的原理吧。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
|
#include <cstdio>
#include <cstdlib>
#include <exception>
void bar(unsigned int n) {
if (n & 1) {
throw std::exception();
}
}
void foo(int n) {
try {
bar(n);
} catch (...) {
printf("exception\n");
}
printf("End\n");
}
int main(int argc, char *argv[]) { foo(atoi(argv[1])); }
|
看看 bar 函数的反汇编(使用 Intel 风格):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| 0x0000000000401995 <+0>: push rbp
0x0000000000401996 <+1>: mov rbp,rsp
0x0000000000401999 <+4>: push rbx
0x000000000040199a <+5>: sub rsp,0x18
0x000000000040199e <+9>: mov DWORD PTR [rbp-0x14],edi
0x00000000004019a1 <+12>: mov eax,DWORD PTR [rbp-0x14]
0x00000000004019a4 <+15>: and eax,0x1
0x00000000004019a7 <+18>: test eax,eax
0x00000000004019a9 <+20>: je 0x4019dc <bar(unsigned int)+71>
0x00000000004019ab <+22>: mov edi,0x8
0x00000000004019b0 <+27>: call 0x401dc0 <__cxa_allocate_exception>
0x00000000004019b5 <+32>: mov rbx,rax
0x00000000004019b8 <+35>: mov rdi,rbx
0x00000000004019bb <+38>: call 0x401a96 <std::exception::exception()>
0x00000000004019c0 <+43>: mov rax,0x402080
0x00000000004019c7 <+50>: mov rdx,rax
0x00000000004019ca <+53>: lea rax,[rip+0xc7dc7] # 0x4c9798 <typeinfo for std::exception>
0x00000000004019d1 <+60>: mov rsi,rax
0x00000000004019d4 <+63>: mov rdi,rbx
0x00000000004019d7 <+66>: call 0x402e30 <__cxa_throw>
0x00000000004019dc <+71>: nop
0x00000000004019dd <+72>: mov rbx,QWORD PTR [rbp-0x8]
0x00000000004019e1 <+76>: leave
0x00000000004019e2 <+77>: ret
|
可以看到汇编中使用 __cxa_throw 将异常抛出,call __cxa_throw 执行结束并不返回到后面的一条汇编,而是跳转到对应的 catch 语句(后文会提及)或 terminate(如果异常不被 catch)。
这是在抛出异常时的部分调用栈(箭头由 调用者 指向 被调用者):
__cxa_throw -> _Unwind_RaiseException -> uw_init_context_1 -> uw_frame_state_for -> _Unwind_Find_FDE -> search_object -> classify_object_over_fdes
__cxa_throw -> _Unwind_RaiseException -> uw_init_context_1 -> uw_frame_state_for -> execute_cfa_program
对这段代码涉及的代码不算太长但也不短,感兴趣的读者可以去 gcc 的源码里面自行查找,Y7n05h 在这里就不放了。
看到这些函数,就不会问出:「一次异常和一次 if-else 的性能比较」的问题了。
注:和一次 if-else 相比,异常机制 必然 有更多的开销。因为抛出异常的机制的代码数量和单次 if-else 相比是多个数量级的差异,根本没有比较的意义。但用这样的对比来说明「错误码」和「异常」这两种错误处理的机制的性能是荒谬的(详见下文)。
因此,异常机制对代码的 bad path 是通常是劣化。
刚刚看完了 throw 的实现,再看看 catch:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
| 0x00000000004019e3 <+0>: push rbp
0x00000000004019e4 <+1>: mov rbp,rsp
0x00000000004019e7 <+4>: push rbx
0x00000000004019e8 <+5>: sub rsp,0x18
0x00000000004019ec <+9>: mov DWORD PTR [rbp-0x14],edi
0x00000000004019ef <+12>: mov eax,DWORD PTR [rbp-0x14]
0x00000000004019f2 <+15>: mov edi,eax
0x00000000004019f4 <+17>: call 0x401995 <bar(unsigned int)>
0x00000000004019f9 <+22>: lea rax,[rip+0x98604] # 0x49a004
0x0000000000401a00 <+29>: mov rdi,rax
0x0000000000401a03 <+32>: call 0x421a00 <puts>
0x0000000000401a08 <+37>: jmp 0x401a3b <foo(int)+88>
0x0000000000401a0a <+39>: mov rdi,rax
0x0000000000401a0d <+42>: call 0x401f30 <__cxa_begin_catch>
0x0000000000401a12 <+47>: lea rax,[rip+0x985ef] # 0x49a008
0x0000000000401a19 <+54>: mov rdi,rax
0x0000000000401a1c <+57>: call 0x421a00 <puts>
0x0000000000401a21 <+62>: call 0x401fa0 <__cxa_end_catch>
0x0000000000401a26 <+67>: jmp 0x4019f9 <foo(int)+22>
0x0000000000401a28 <+69>: mov rbx,rax
0x0000000000401a2b <+72>: call 0x401fa0 <__cxa_end_catch>
0x0000000000401a30 <+77>: mov rax,rbx
0x0000000000401a33 <+80>: mov rdi,rax
0x0000000000401a36 <+83>: call 0x4102f0 <_Unwind_Resume>
0x0000000000401a3b <+88>: mov rbx,QWORD PTR [rbp-0x8]
0x0000000000401a3f <+92>: leave
0x0000000000401a40 <+93>: ret
|
若 bar 不抛出异常,0x00000000004019f4 <+17>: call 0x401995 <bar(unsigned int)> 执行完成后会正常返回至 0x00000000004019f9 <+22>: lea rax,[rip+0x98604] # 0x49a004;若 bar 抛出异常,执行完这次 0x00000000004019f4 <+17>: call 0x401995 <bar(unsigned int)> 后会回到 0x0000000000401a0a <+39>: mov rdi,rax。
可以看到这个 try { ... } 其实并没有开销,开销在 catch 上。
与使用错误码相比,使用异常的方案在 happy path(不抛出异常的情况) 上,消除了一次条件跳转(或多次条件跳转,如果结果需要在多层函数调用间逐层返回的话),众所周知,条件跳转是有可能带来 分支预测惩罚 的。因此,异常机制对代码的 happy path 是优化。
再看看 __cxa_begin_catch 和 __cxa_end_catch 的部分调用栈(箭头由 调用者 指向 被调用者):
__cxa_begin_catch -> __cxa_get_globals
__cxa_end_catch -> __cxa_get_globals_fast
__cxa_end_catch -> _Unwind_DeleteException
这些调用栈都很浅。对整个 throw、catch 的机制来说,复杂度在 throw 上,catch 只做了很少的工作,这一点从调用栈的长度也能看出一点端倪。
是否该使用异常?
上文的讨论中,已经说明了异常机制在代码的 happy path 比错误码具有更多的优势,在 bad path 与错误码相比则具有劣势。
在较深的调用栈中逐层返回错误码可能需要使用多次 if-else 完成多次条件跳转,这也带来了多次潜在的 分支预测惩罚 。此时使用异常所需的成本 可能 相对较低。
高效使用异常必然该是 扬长避短 的,只讨论 happy path 上 exception 的优势,或是只讨论 bad path 上 exception 的劣势都是片面的。
讨论异常的使用必然需要综合这两方面的影响。
因此,在绝大多数情况都在 happy path 时,happy path 带来的优化比 bad path 带来的劣化多,使用异常才比使用错误码有优势。
回到最开始的 leetcode 题目上去,异常在查找 LRU 缓存中不存在的 key 时被抛出,显然不是(至少在这个测试的情景中显然不是)极少数情况。Y7n05h 在这里的对异常的用法,将异常作为了一种常见情况的控制流,已经背离了扬长避短的做法,性能差也就不奇怪了。
更详细、严谨的说明异常和一些别的处理错误的方式的比较,以及何时该使用异常请看参考资料 1 和参考资料 2。
异常的原理
对于 Y7n05h 而言,至此已经解决所遇到的问题了:异常有多慢,异常的正确使用场景是什么也都有了答案。
这一段只是为了浅浅的看看为什么 throw 会那么慢,这也就需要看看 __cxa_throw 究竟是怎么实现的。
如需详细、具体的了解 C++ 异常的实现原理请看参考资料 3,那是非常棒的资料。
—
在抛出异常时,程序需要在 ELF 的 .eh_frame section 的信息的指导下完成对栈的两次遍历(一次用来查找 catch 一次用来逐层的对栈上的元素执行析构)。
.eh_frame section 占据的空间一点也不小。
对上面用作示例的 SimpleException.cpp 程序 .eh_frame section 占据了 0x108 bytes,而 .text section 也才占据了 0x1ef bytes。
参考资料
1:Bjarne Stroustrup. C++ exceptions and alternatives[G/OL]. http://www.open-std.org/jtc1/sc22/wg21/docs/papers/2019/p1947r0.pdf.
2:Herb Sutter. Zero-overhead deterministic exceptions: Throwing values[G/OL]. http://www.open-std.org/jtc1/sc22/wg21/docs/papers/2019/p0709r4.pdf.
3:Nico Brailovsky. C++ exceptions under the hood[G/OL]. https://monkeywritescode.blogspot.com/p/c-exceptions-under-hood.html.
4:江召伟. c++ 异常处理[G/OL]. https://www.cnblogs.com/jiangzhaowei/p/4989197.html.